이석영
Lee Seokyoung Backend / Full-stack Developer 실무 1년 10개월문제의 원인을 끝까지 규명하고, 같은 문제가 재발하지 않는 구조로 해결하는 개발자입니다.
눈앞의 오류만 제거하면 유사한 문제가 다른 형태로 다시 돌아오고, 유지보수 비용도 함께 늘어난다고 생각합니다. 따라서 처음 떠오른 원인을 정답으로 단정하지 않고, 코드와 실행 환경을 직접 추적하여 근본 원인을 검증합니다.
해결 방안을 선택할 때는 당장의 편의보다 향후 유지보수와 확장이 용이한지를 우선 고려합니다. 서비스 개발, 데이터 처리, 비동기 작업, 인프라 전반을 직접 다루며, 운영 단계에서 드러나는 문제의 해결까지 책임집니다.
Vulinder · 통합 보안 점검 SaaS 개발
- SAST·SCA·DAST 등 7종 보안 점검을 통합한 SaaS 설계·개발·운영 (1인)
- 아키텍처·API/DB 명세·개발/운영 가이드 등 기술 문서 11종 작성, 합류 개발자 온보딩 기반 마련
- 스캐너 OOM으로 결과가 0건 처리되던 문제를 설치 목록 기반 분석으로 전환해 해결 (0 → 5,706건)
- 원본 반복 파싱을 없앤 정규화 테이블 설계로 취약점 상세 조회 2.5초 → 0.2초 미만
- 멀티 파드 전환 시 이벤트 유실·작업 중복 실행을 Redis Pub/Sub, DB 분산 락으로 해소
- 멱등키·조직 단위 락·결제 확인 대기 상태로 구독 결제 이중 청구 차단
- WireGuard VPN 헬퍼(Go) 구현, MTU 조정으로 고객 사설 클러스터 점검 연동 (2,895건 탐지)
SITE NOTE · 캡처·협업 SaaS
- 전체 아키텍처 설계 및 프론트엔드·API 개발 (Next.js·NestJS)
- 브라우저 확장 기반 전체 페이지 캡처 개발
- 비동기 워커·큐 기반 캡처 파이프라인 구축 (BullMQ·Redis)
- AWS EC2·Nginx 인프라 구축 · 운영
EMS · 에너지 모니터링 시스템 개발
- 전력·태양광 계측 데이터 수집·집계 시스템의 화면, API, 배치 개발 및 운영 (2인)
- Paging Reader를 Cursor Reader로 교체해 600만 건 배치 5일 이상 → 20분 단축
- 데이터 처리 순서 재설계로 관리자 DB와 장치 시스템 간 데이터 불일치 해소
- 타임존 이중 변환으로 인한 데이터 삭제 기준 오류 원인 규명 및 수정
WMS · 창고 관리 시스템 개발
- 종이 기반 입·출고 및 재고 관리 업무를 웹 시스템으로 전산화
- 입·출고 이력 기반 재고 계산 구조로 재고 불일치 해소 및 이력 추적 구현
- 종이 처리 대비 입·출고 업무 처리 시간 50% 이상 단축
공통 기능·인프라·R&D
- 사내 공용 JS 라이브러리 개발 (트리 시각화·Table Editor·Time Bar)
- AWS EC2·Nginx 기반 서비스 인프라 구축·운영 및 Jenkins 빌드·배포 파이프라인 구축
- 국가 연구개발사업 수행 및 C# 기반 성과 관리 프로그램 개발
일하는 방식
정해진 기획이 없던 서비스를, 요구사항을 직접 구체화하며 만들어 왔습니다.
Vulinder는 초기 기획 단계부터 제가 직접 구체화하며 시작한 서비스입니다. 대표님께서 제시하신 방향을 바탕으로 관련 자료를 조사하고, 더 나은 방안이 있으면 근거와 함께 제안드리며 기능을 하나씩 만들어 나갔습니다.
이후 기획자가 합류하면서부터는 요구사항 수집 → 자료 조사 → 적용 방식 설계 → 기획팀 논의의 흐름으로 함께 서비스를 끊임없이 개선해 왔습니다.
혼자 개발하던 시기에는 다양한 의견을 듣기 어려워 판단에 주관이 섞이기 쉽다는 한계가 있었습니다. 기획자와 논의하며 서로 다른 시각이 더해질 때 결정이 더 단단해진다는 것을 체감했습니다.
문서화 · 지식 공유
그동안 쌓아 온 구조를, 팀 누구나 참고할 수 있는 문서로 정리했습니다.
팀원이 합류하면서, 그동안 저만 알고 있던 설계 의도와 결정 배경을 팀이 함께 볼 수 있도록 서비스 전체를 문서로 정리했습니다. 설계·명세·가이드·프로세스 네 영역에 걸쳐 총 9종이며, 문서마다 번호와 버전을 부여해 관리했습니다.
합류한 팀원은 아키텍처 설계서와 모듈 구성도를 보며 서비스 구조를 빠르게 파악했고, 개발 환경 구축 가이드와 배포·운영 가이드만으로 별도의 설명 없이 배포까지 직접 성공했습니다.
AI 활용
AI로 속도를 높이되, 방향을 정하고 검증하는 일은 직접 맡습니다.
AI를 개발에 적극 활용하면서, 결과물의 품질이 그때그때 달라지지 않도록 하네스(작업 환경)를 직접 구성했습니다. 매 세션 프로젝트의 작업 규약을 자동으로 불러오게 하고, 타입체크·린트·테스트·빌드 검증을 모두 통과해야 작업이 마무리되도록 했습니다.
작업을 맡길 때는 스펙 작성 → 구현 계획 → 검토·선택 → 구현 → 테스트의 순서를 지킵니다. 코드를 작성하기 전에 무엇을, 어떻게 만들지부터 문서로 정리하게 하는 것입니다.
방향이 갈리는 지점에서는 AI가 3~4개의 선택지를 장단점과 함께 제시하도록 하고, 최종 선택은 제가 내립니다. 선택한 이유는 결정 로그로 남겨, 나중에도 왜 그렇게 결정했는지 되짚어 볼 수 있게 했습니다.
Vulinder
2026.06 ~ 현재소스코드부터 서버 인프라까지, 흩어진 보안 분석 결과를 한 화면에서 관리하는 SaaS
- CASE 01중복 실행 제거멀티 파드 이벤트·예약 작업 (Pub/Sub, 분산 락)
- CASE 022.5초→0.2초 미만취약점 상세 로딩 (정규화 설계)
- CASE 032,895건사설 클러스터 취약점 탐지 (VPN)
- CASE 04이중 청구 차단구독 결제 (멱등키, 조직 락, 확인 대기 상태)
- CASE 050건→5,706건OS 패키지 취약점 탐지 (분석 구조 개선)
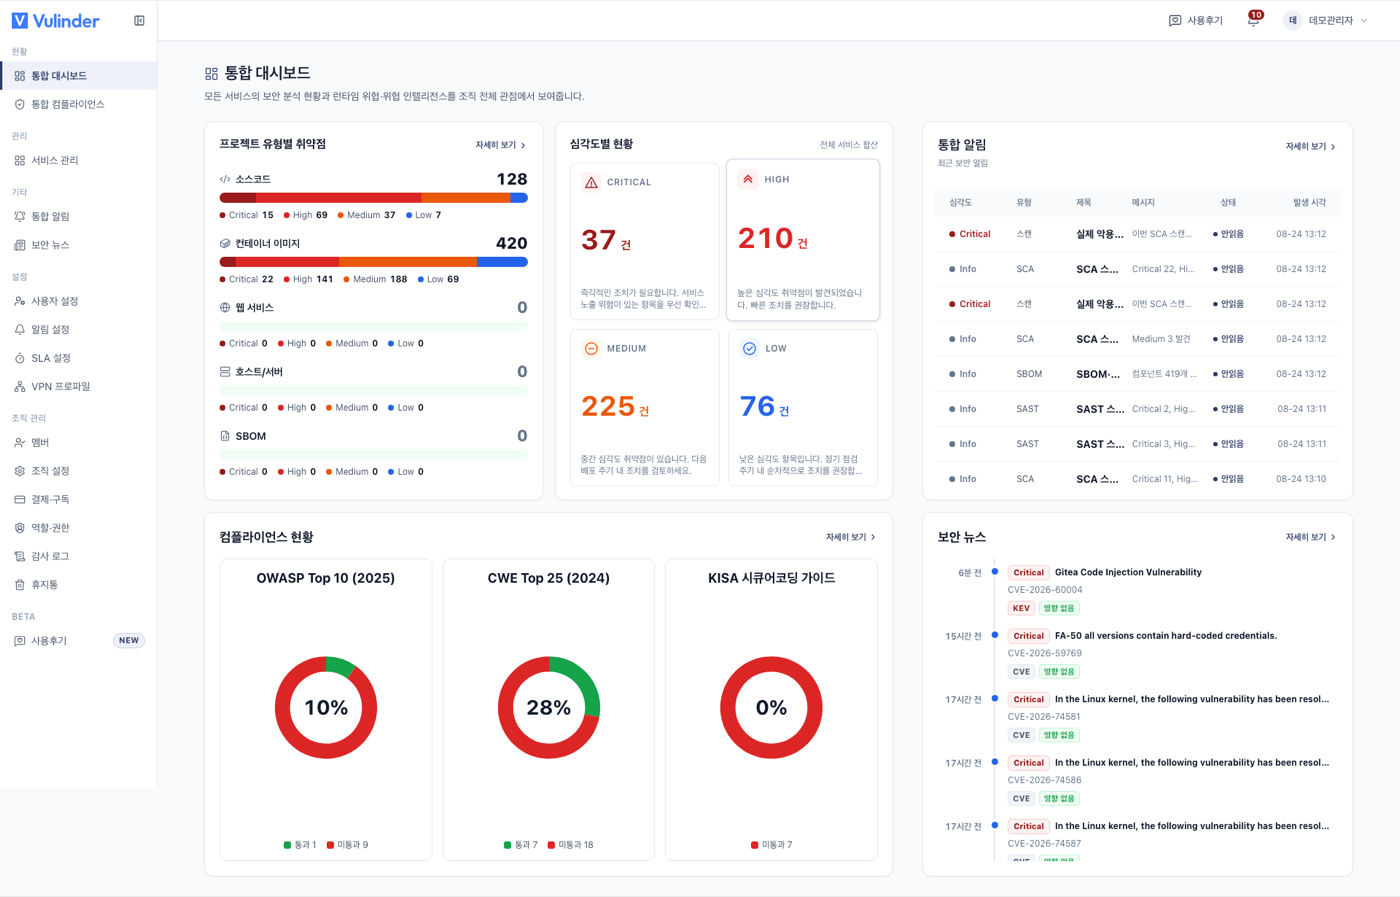
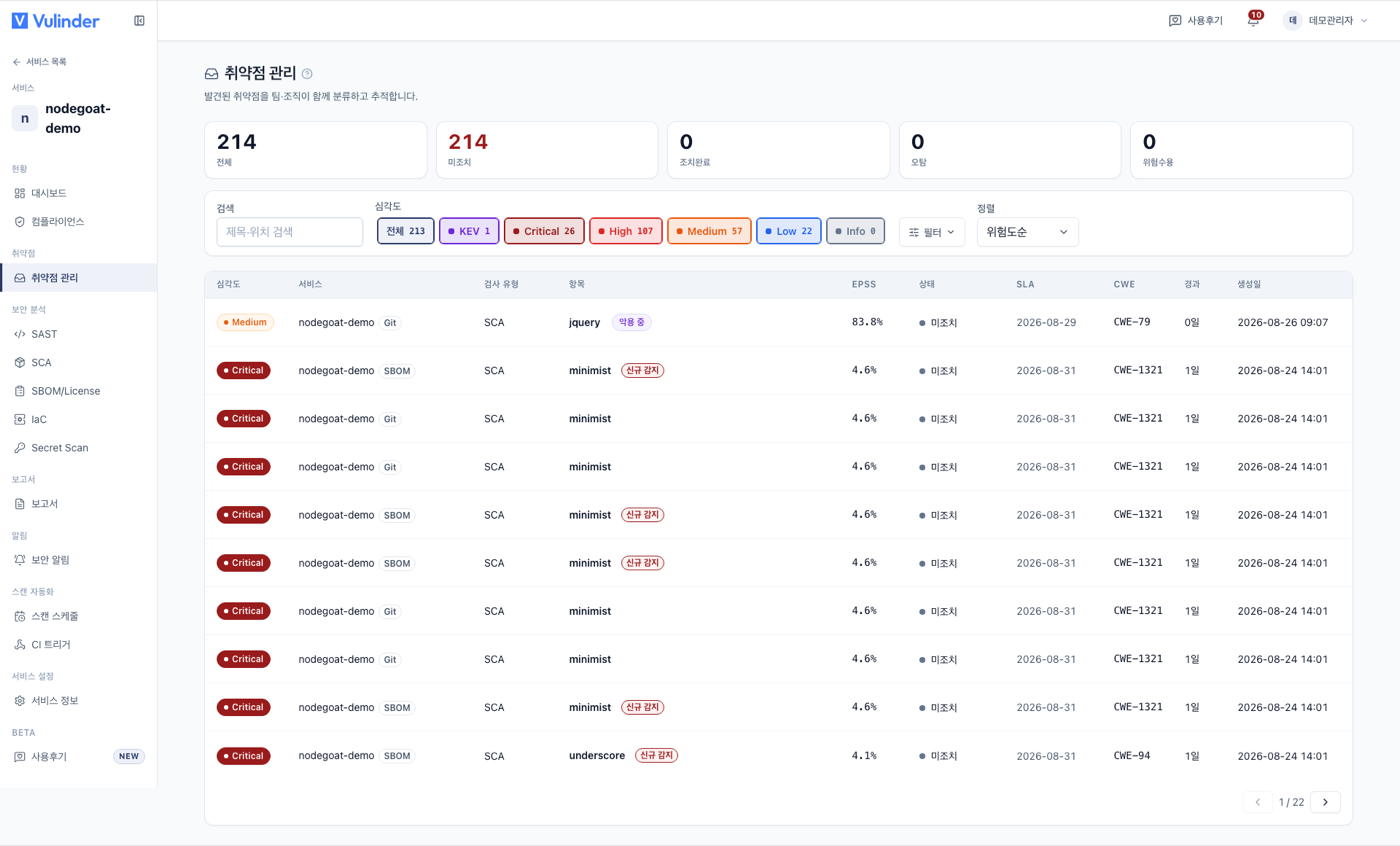
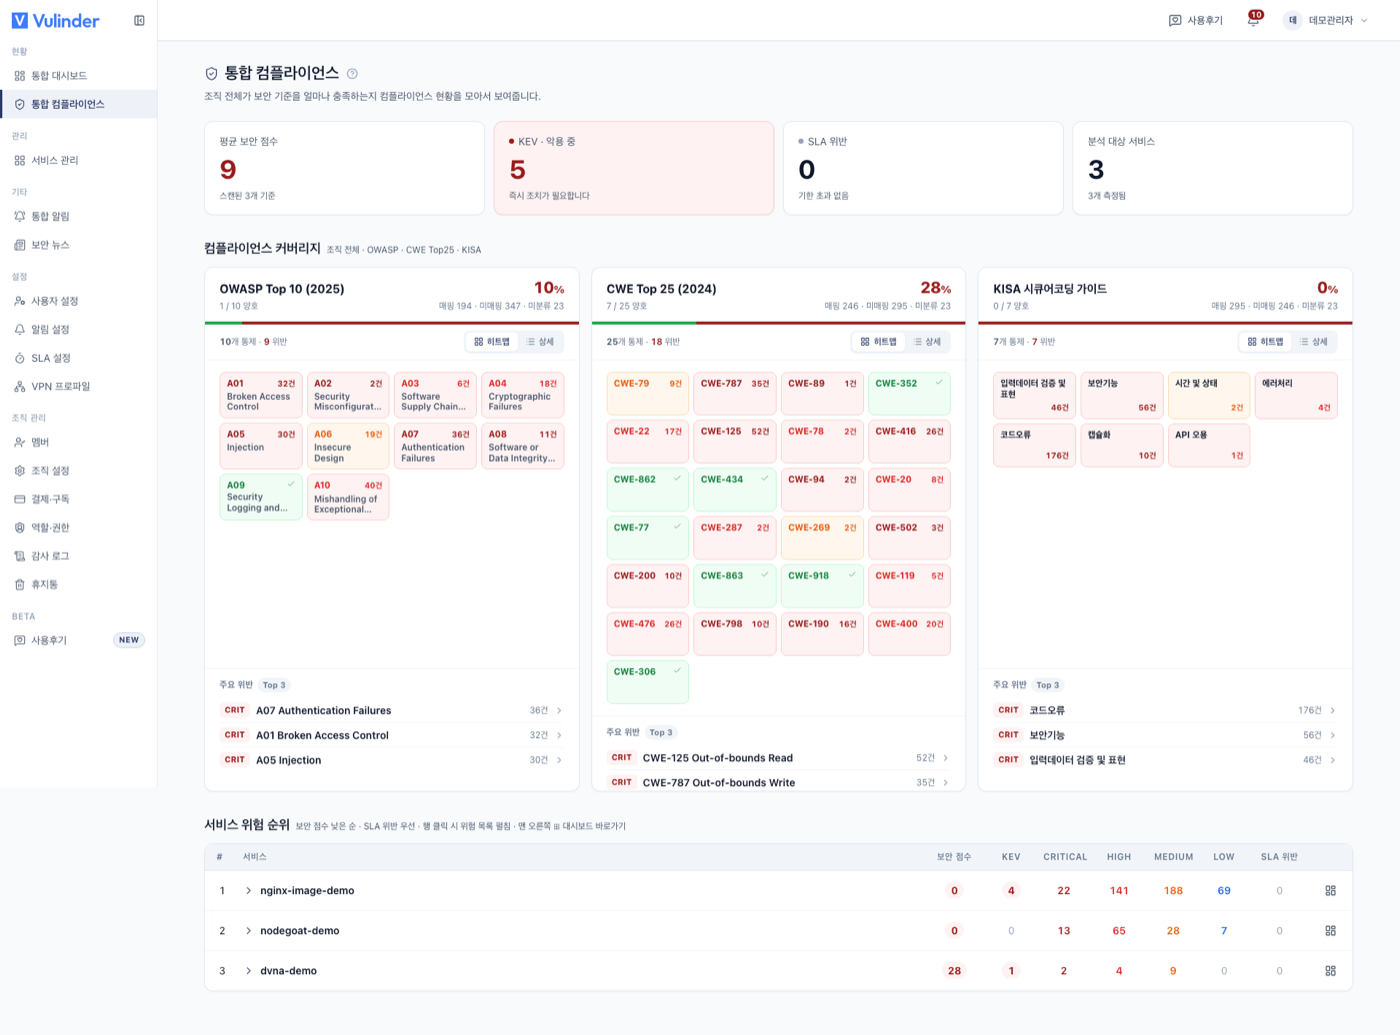
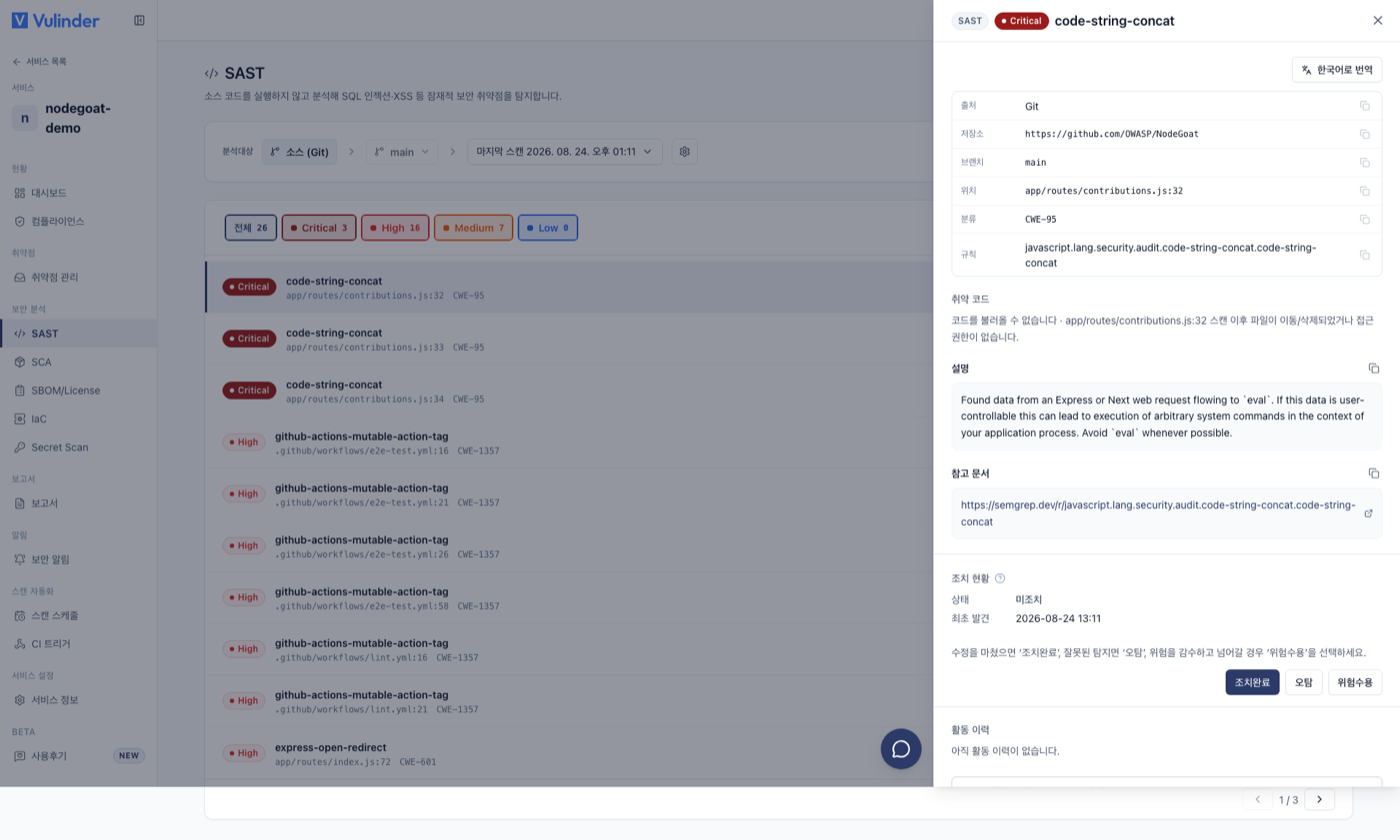
소스코드, 컨테이너 이미지, 웹 서비스, 서버 인프라, 런타임의 보안 점검을 하나로 통합한 보안 취약점 관리 SaaS입니다. SAST · SCA · DAST · SBOM · IaC · Secret · License 분석을 한곳에서 제공합니다.
역할 · 서비스 전체 아키텍처 설계 및 풀스택 개발 (API·프론트엔드·인프라 구축 전담, 2026.09부터 팀원 1명과 함께 개발 리드)
시스템 아키텍처
제품 화면
문제 해결 기록
멀티 파드 전환에서 드러난 이벤트 유실과 작업 중복 실행
- 문제멀티 파드 환경의 이벤트 유실·작업 중복 실행 및 조직 간 이벤트 노출
- 해결Redis Pub/Sub 이벤트 공유 및 DB 분산 락 적용
- 성과파드 간 이벤트 전달, 중복 실행 제거 및 조직 간 정보 노출 차단
상세 보기 (원인 분석 · 설계 결정)상세 접기
출시를 앞두고 서버를 여러 파드로 운영하기로 하면서 멀티 파드 환경을 점검했고, 두 가지 문제를 확인했습니다.
첫째, 실시간 이벤트가 일부 사용자에게만 전달됐습니다. 스캔 완료를 처리한 파드에 연결된 사용자만 진행률과 알림을 받았고, 다른 파드에 연결된 사용자는 새로고침 전까지 받지 못했습니다.
둘째, 같은 작업이 파드 수만큼 실행됐습니다. 예약 스캔 실행, 보안 점수 기록, 보안 뉴스와 CVE 정보 갱신 같은 예약 작업(크론)이 모든 파드에서 동시에 실행됐고, 호출 횟수 제한이 있는 외부 취약점 데이터 API도 중복으로 호출했습니다. 같은 조직의 스캔을 두 파드가 동시에 할당받으면 조직별 동시 실행 한도를 초과하는 경우도 있었습니다.
또한 점검 과정에서 스캔 진행 이벤트가 조직 구분 없이 전송돼, 다른 조직의 서비스 이름과 취약점 집계가 노출되는 문제도 발견했습니다.
실시간 기능과 예약 작업을 처음 만들 때 멀티 파드 환경을 고려하지 못했습니다. 연결 목록은 각 파드의 메모리에만 있었고, 예약 작업은 같은 작업을 다른 파드가 이미 실행하고 있는지 확인하지 않았습니다. 조직별 한도는 실행 수를 확인한 뒤 상태를 바꾸는 두 단계 사이에 다른 파드가 끼어들 수 있었습니다.
조직 간 노출은 멀티 파드와 별개의 원인으로, 이벤트를 보낼 때 수신자의 소속 조직을 확인하지 않았습니다.
- ① Redis Pub/Sub으로 파드 간 이벤트 공유 · 스캔 완료를 처리한 파드는 해당 파드에 연결된 사용자에게 이벤트를 보내고, 같은 이벤트를 Redis 채널에 발행합니다. 다른 파드들은 이 채널을 구독하고 있다가 이벤트를 받아 연결된 사용자에게 전달합니다. 채널의 이벤트는 발행한 파드에도 전달되므로, 발행한 파드는 자신의 이벤트를 무시해 같은 알림이 두 번 가지 않게 했습니다.
- ② 같은 조직에만 전송 · 사용자가 연결할 때 어느 조직 소속인지 기록해 두고, 이벤트마다 어느 조직의 스캔인지 담았습니다. 조직이 일치하는 사용자에게만 전달하고, 조직을 확인할 수 없는 이벤트는 아무에게도 보내지 않습니다.
- ③ DB 분산 락으로 예약 작업 한 번만 실행 · 예약 작업이 시작될 때 DB 락(
GET_LOCK)을 먼저 획득하도록 했습니다. 락을 획득한 파드만 실행하고, 획득하지 못한 파드는 다른 파드가 실행 중이라는 뜻이므로 그 회차를 건너뜁니다. 이 처리를 공통 함수로 만들어 예약 작업 전반(17곳)에 적용했습니다. - ④ 조직 단위 락으로 동시 실행 한도 지키기 · 스캔을 할당할 때 "현재 실행 수 확인 → 실행 상태로 변경"을 조직 단위 락으로 묶었습니다. 두 파드가 같은 조직의 스캔을 동시에 할당받으려 해도, 한쪽이 확인과 변경을 마친 뒤에야 다른 쪽이 확인합니다.
이벤트 공유의 일반적인 해법은 socket.io의 Redis 어댑터입니다. 하지만 현재 서비스는 기본 WebSocket으로 만들어져 있어, 이를 쓰려면 WebSocket 게이트웨이 3곳과 프론트엔드 연결 코드를 모두 바꿔야 했습니다. 출시 직전이라 필요한 기능만 담은 작은 중계 모듈을 직접 만들었습니다. 분산 락도 Redis에 새로 만들지 않고, 스캔 큐에서 이미 쓰고 있던 DB 락을 그대로 재사용했습니다.
- 파드 간 이벤트처리한 파드만→모든 파드
- 예약 작업파드 수만큼 실행→회차당 1번
- 조직 동시 실행 한도동시 요청 시 초과→유지
- 조직 격리전체 전송→같은 조직만
스캔 결과 정규화 및 조회 성능 개선
- 문제취약점 상세 조회 시 원본 데이터 조회에만 약 2.5초 소요
- 해결정규화 테이블 설계 및 저장 시점 파싱·정규화 적용, 조회용 인덱스와 중복 방지 제약 조건 추가
- 성과취약점 상세 조회 시간 약 2.5초 → 0.2초 미만 단축
상세 보기 (원인 분석 · 설계 결정)상세 접기
스캔 결과를 표시하는 화면 전반에서 응답 지연이 반복됐습니다. 측정 결과, 스캔 원본 데이터는 최대 8.48MB였으며 DB에서 원본을 조회하는 데만 2,497ms가 소요됐습니다.
초기에는 인덱스 누락을 의심했지만, 운영 DB를 확인한 결과 필요한 인덱스는 이미 존재했고 테이블의 행 수도 많지 않았습니다. 원인은 조회 방식과 데이터 저장 구조에 있었습니다.
스캔 결과 전체를 JSON 형태로 단일 컬럼에 저장하고 있어, 화면을 조회할 때마다 원본을 가져와 파싱해야 했습니다. 취약점 상세 화면은 취약점 한 건을 조회하기 위해 전체 결과를 파싱한 뒤 해당 항목을 탐색했고, 대시보드는 집계 수치를 계산하기 위해 최대 2,000건의 결과를 반복해서 파싱했습니다.
- ① 정규화 테이블 설계 · 취약점 한 건을 한 행으로 저장하는 공통 테이블과 점검 유형별 상세 테이블로 나눴습니다. 자주 조회하는 값은 컬럼으로 분리해 인덱스를 추가했고, UNIQUE 제약으로 중복 저장을 막았습니다.
- ② 조회 시점의 파싱을 저장 시점으로 이전 · 스캔 완료 시 원본 JSON을 한 번 파싱해 정규화 테이블에 저장하도록 변경했습니다. 정규화 작업은 사용자 요청 처리와 분리된 비동기 흐름에서 수행하도록 설계해, 데이터 가공 비용이 조회 응답 시간에 직접 반영되지 않도록 했습니다.
- ③ 원본 데이터와 조회 데이터 분리 · 원본 JSON과 실행 로그는 재현 및 감사 목적으로 별도 보관하고, 화면 조회는 정규화 테이블을 사용하도록 변경했습니다. 전환 전후 데이터의 정합성을 검증하기 위해 기존 방식과 변경 방식의 결과 2,313건을 비교했으며, 모든 결과가 일치하는 것을 확인했습니다.
문제의 원인은 데이터 자체의 조회보다 조회할 때마다 반복되는 원본 파싱과 탐색에 있었습니다. 캐시를 적용하면 캐시 미스 시 동일한 비용이 다시 발생하고, 근본적인 비효율은 남게 됩니다.
따라서 조회 구조를 먼저 개선하고, 스캔 완료 시점에 정규화된 데이터를 저장해 화면에서 바로 활용하도록 변경했습니다. 이를 통해 별도의 캐시 인프라 없이도 반복 파싱을 제거하고 조회 성능을 개선했습니다.
- 상세 조회 (최대 원본)약 2.5초→0.2초 미만 (인덱스 조회 1회)
- 상세 조회 (그 외 원본)원본 전송 1,319ms→원본 전송 없이 1행 조회
- 조직 대시보드서비스마다 원본 5종 파싱→쿼리 2~3개
사설 클러스터 VPN 연동과 TLS 핸드셰이크 타임아웃 해결
- 문제VPN 터널 환경에서 TLS 핸드셰이크 타임아웃 발생
- 해결MTU 하향 조정 및 점검 범위 축소
- 성과VPN 경유 취약점 2,895건 탐지 및 클러스터 설정 점검 정상 완료
상세 보기 (원인 분석 · 설계 결정)상세 접기
고객사 사내망의 서버와 클러스터는 백엔드에서 바로 접근할 수 없어 VPN(WireGuard)이 필요했습니다. 운영체제 내장 WireGuard는 관리자 권한이 필요해 컨테이너 환경에 맞지 않았고, 그래서 VPN 처리를 일반 프로세스로 수행하는 Go 헬퍼를 만들었습니다. 이 헬퍼를 통해 사설 클러스터 스캔이 정상 동작해 취약점 2,895건을 탐지했습니다.
그러나 클러스터 설정 점검은 TLS 핸드셰이크 단계에서 70초 만에 타임아웃이 발생했습니다. 연결은 정상적으로 수립됐지만, 인증서처럼 큰 데이터를 주고받는 구간에서만 응답이 멈췄습니다.
VPN은 패킷을 한 번 더 캡슐화해 전송합니다. 캡슐화로 커진 패킷이 경로가 허용하는 크기(MTU)를 넘으면서 큰 패킷만 중간에 버려졌습니다. 그래서 작은 패킷만 오가는 연결 수립은 통과하고, 인증서가 오가는 TLS 핸드셰이크만 실패했습니다.
원래는 "패킷이 너무 크다"는 신호가 돌아와 보내는 쪽이 크기를 줄입니다. 하지만 이 신호는 운영체제가 받고, 관리자 권한 없이 일반 프로세스로 동작하는 헬퍼에는 전달되지 않습니다. 권한 문제를 피하려고 고른 방식 때문에 패킷 크기를 자동으로 조정하지 못했습니다.
또한 이 점검은 클러스터 전체 리소스를 한 번에 조회해, 터널에 동시에 몰리는 연결이 처리 한도를 넘었습니다. MTU를 조정한 뒤에도 점검이 완료되지 않은 원인입니다.
- ① MTU 조정과 응답 잘림 버그 수정 · 터널 MTU를 1420 → 1280으로 낮췄습니다. 이 과정에서 한쪽이 전송을 마치면 연결 전체를 닫아 큰 응답이 중간에 잘리던 버그를 발견해, 전송을 마친 방향만 닫도록 고쳤습니다. 그 결과 70초 만에 끊기던 점검이 4분 넘게 이어졌지만, 완료되지는 않았습니다.
- ② 점검 범위 축소 · 클러스터 스캔에서 이미 쓰던 네임스페이스 단위 범위 지정을 이 점검에도 적용해 동시 연결 수를 줄이고, 일시적인 연결 실패는 1회 재시도하도록 했습니다. 이후 점검이 끝까지 완료됐습니다.
- ③ MTU를 설정값으로 분리 · 운영 환경은 경로상 캡슐화가 한 번 더 이루어져 1280으로도 부족했습니다. 코드에 고정돼 있던 MTU를 설정값으로 분리해 다시 빌드하지 않고 환경마다 조정할 수 있게 했습니다(운영은 1200).
1280은 IPv6가 모든 네트워크에 보장하도록 정한 최소 크기라, 대부분의 경로를 통과하는 안전한 출발점입니다. 운영에서 경로마다 한계가 다르다는 것을 확인한 뒤에는 안전한 기본값을 두고 환경마다 조정하는 방식으로 마무리했습니다.
- 클러스터 설정 점검70초 타임아웃→완료
- VPN 경유 취약점 탐지2,895건 (관리자 권한 불필요)
- 대용량 응답중간 잘림 제거
- MTU 조정다시 빌드→설정값 변경
구독 결제의 이중 청구 위험과 멱등 결제 구조 적용
- 문제동시 요청과 결제사 응답 오류 시 이중 청구 위험
- 해결멱등키, 조직 단위 락, 결제 확인 대기 상태 적용
- 성과이중 청구 경로 차단 및 결제 E2E 점검 67개 항목 통과
상세 보기 (원인 분석 · 설계 결정)상세 접기
구독 결제 구현을 마친 뒤, 여러 파드로 운영하는 환경을 기준으로 결제 코드를 다시 점검했습니다. 그 결과 고객에게 두 번 청구될 수 있는 경로 두 가지를 확인했습니다.
첫째, 결제 버튼을 연달아 누르거나 여러 파드가 같은 구독을 동시에 처리하면 두 번 청구될 수 있었습니다. 둘째, 결제사가 오류나 타임아웃으로 응답하면 실제 결제 여부와 관계없이 실패로 처리했습니다. 결제가 실제로 됐다면 돈은 나갔는데 서비스가 제공되지 않고, 다음 갱신 작업이 같은 기간을 다시 청구할 수 있었습니다.
결제 요청에 동시 실행을 막는 장치가 없었습니다. 결제 시도 번호도 기존 건수에 1을 더해 정했기 때문에, 동시에 들어온 요청이 같은 번호를 받을 수 있었습니다.
또한 결제사 응답을 성공과 실패로만 나눠, 응답이 끊겨 결과를 알 수 없는 경우를 다루지 못했습니다.
- ① 멱등키 · 결제마다 "구독, 결제 주기, 시도 번호"로 정해지는 고유 ID를 붙이고 UNIQUE 제약을 걸었습니다. 같은 결제는 같은 ID를 가지므로 두 번 기록되지 않습니다. 기존에 연월 기준이던 키를 결제 주기 번호로 바꿔, 재구독할 때 키가 겹치는 문제도 함께 없앴습니다.
- ② 조직 단위 락 · 청구 전에 조직 단위 DB 락(
GET_LOCK)을 잡고, 락 안에서 이번 주기에 완료됐거나 확인 대기 중인 결제가 있는지 다시 확인했습니다. 있으면 청구하지 않습니다. 락을 얻지 못하거나 락 상태가 불분명할 때도 청구하지 않도록 해, 애매한 상황에서는 결제가 나가지 않게 했습니다. - ③ 결제 확인 대기 상태 · 결제사가 서버 오류나 타임아웃으로 응답하면 실패로 확정하지 않고 확인 대기 상태로 둡니다. 30분 주기 작업이 결제사에 다시 조회해 최종 확정하며, 그동안에는 같은 결제를 다시 청구하지 않습니다.
- ④ 결제 완료는 한 번만 반영 · 결제 완료 처리는 대기 상태인 결제에만 적용되도록 조건을 걸었습니다. 웹훅과 재조회 작업이 같은 결제를 동시에 확정하려 해도 한 번만 반영됩니다.
결제사 호출은 외부 API라 DB 트랜잭션으로 되돌릴 수 없고, 트랜잭션 안에서 응답을 기다리면 그동안 다른 결제까지 막힙니다. 그래서 동시 실행은 락으로 막고, 정확성은 멱등키와 결제 상태로 맞췄습니다.
- 동시 구독 요청이중 청구 가능→청구 1건
- 불확실한 결제사 응답실패로 확정→재조회 후 확정
- 결제 E2E 점검67개 항목 통과
- 점검 중 발견한 결제 버그3건 수정
서버 OS 패키지 스캔의 메모리 초과와 분석 구조 개선
- 문제OS 패키지 취약점 스캔 결과 0건 집계
- 해결패키지 DB 대신 설치 목록 기반 분석으로 전환
- 성과OS 패키지 취약점 0건 → 5,706건 탐지
상세 보기 (원인 분석 · 설계 결정)상세 접기
운영 서버의 OS 패키지 취약점 스캔 결과가 0건이었고, 스캔 실패를 알리는 신호도 남지 않았습니다.
접속 경로와 스캐너 설정은 정상이었습니다. 이 서버의 rpm 패키지 DB가 181MB까지 커져 있었고, 스캐너는 이를 파싱하는 과정에서 메모리 사용량이 2.9GB를 넘어 강제 종료(OOM)됐습니다.
스캐너는 수집한 파일을 한 번에 분석하기 때문에, 분석 중 프로세스가 종료되면 함께 넣은 다른 파일의 결과까지 사라집니다. 이 종료가 실패가 아니라 "결과 0건"으로 전달됐습니다.
- ① DB 대신 설치 목록 · 서버에서
rpm -qa로 설치된 패키지 목록만 가져와 표준 구성요소 목록(SBOM)으로 변환한 뒤 스캐너에 넘겼습니다. 입력이 181MB 패키지 DB에서 패키지 이름과 버전 목록으로 바뀝니다. - ② 수집 실패 시 명시적 오류 처리 · OS 종류를 판별하지 못하거나 패키지 목록이 비어 있으면, 0건으로 넘기지 않고 오류로 중단하게 했습니다.
- ③ OS 식별 파일 수집 · Ubuntu 서버의 0건은 별도 원인이었습니다. 수집기가 OS 종류를 알려 주는 파일을 수집하지 않아 스캐너가 OS를 인식하지 못했고, 해당 파일을 수집 목록에 추가했습니다.
rpm DB 크기는 서버마다 다르고 시간이 갈수록 커집니다. 한도를 얼마로 잡든 더 큰 서버에서 같은 문제가 재발합니다. 입력을 설치 목록으로 바꾸면 크기를 예측할 수 있습니다.
- OS 패키지 취약점0건→5,706건 탐지
- 스캐너 메모리OOM(2.9GB 이상) 제거
- 수집 실패0건으로 처리→오류로 중단
SITE NOTE
2025.12 ~웹 페이지 전체를 저장하고, 캡처 위에 주석을 남겨 팀과 공유하는 협업 SaaS
- CASE 012GB→600MB이미지 처리 피크 메모리 (타일 단위 합성)
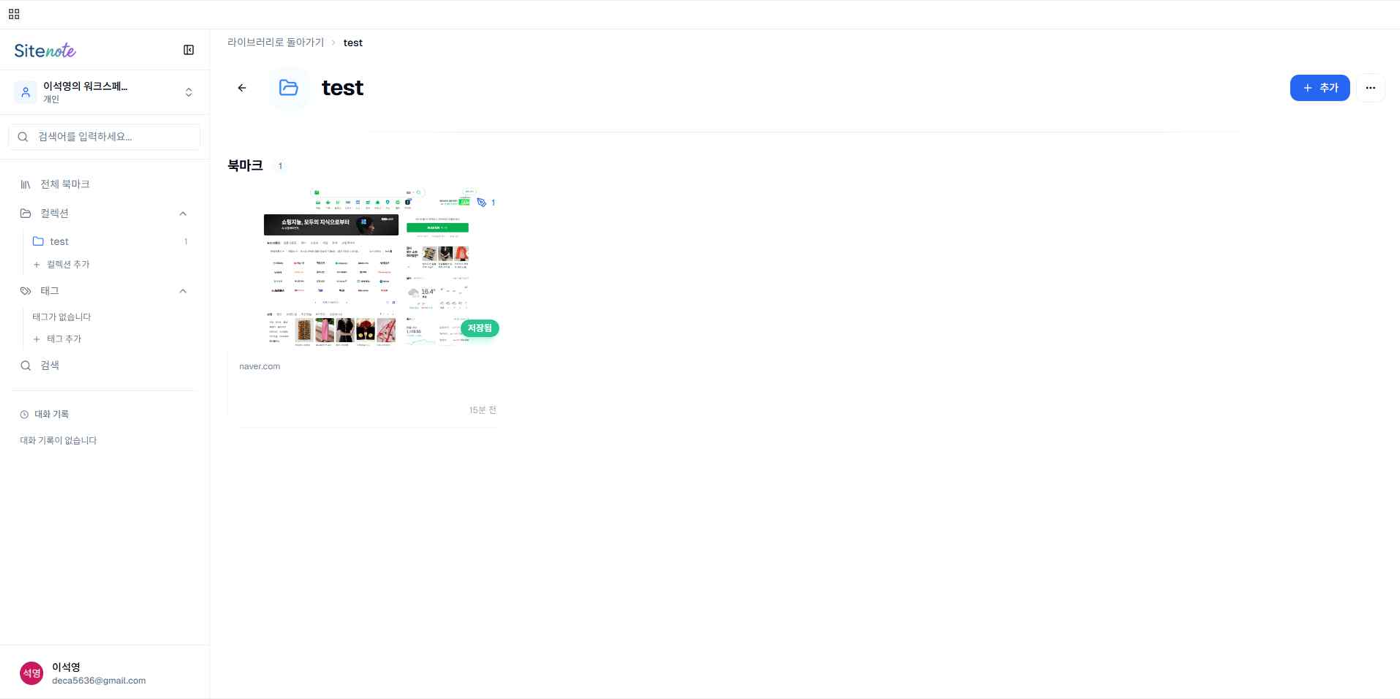
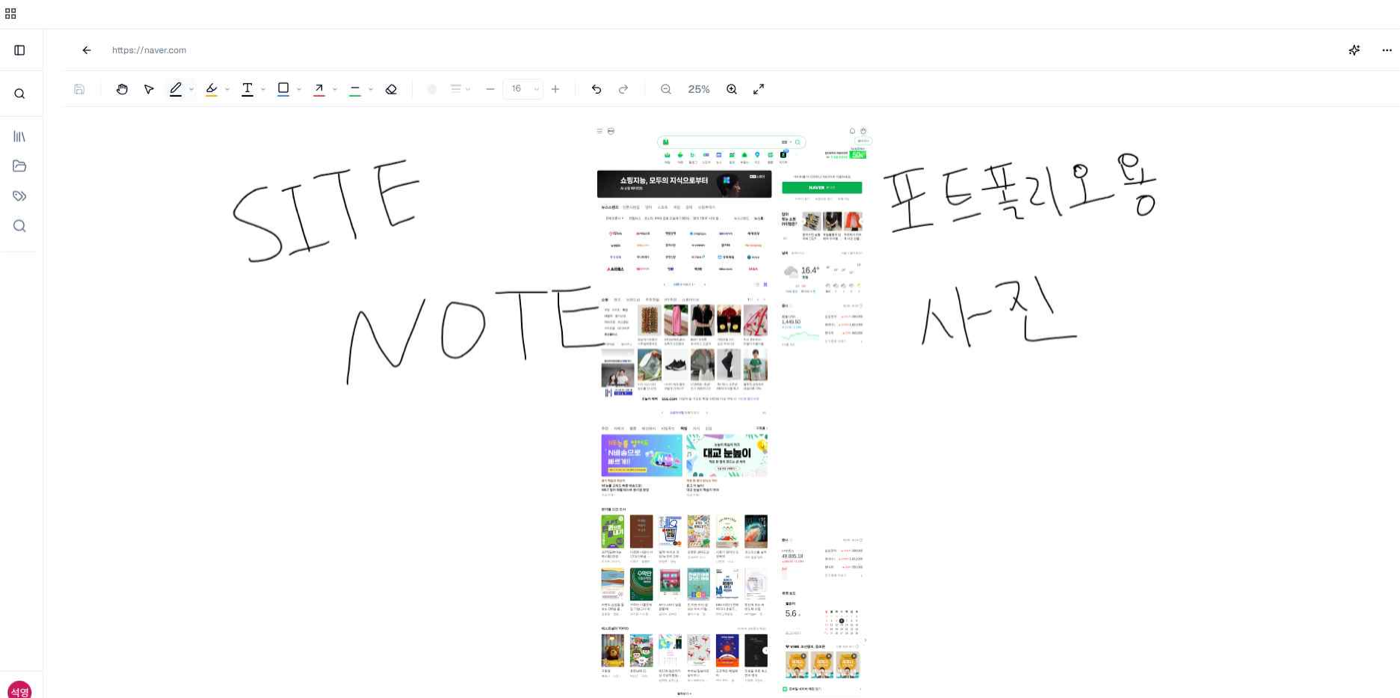
웹 페이지 전체를 캡처해 캔버스로 주석을 달고, 태그·컬렉션으로 정리하며, 저장한 페이지를 바탕으로 AI에게 질문할 수 있는 협업 SaaS입니다. 브라우저 확장으로 전체 페이지를 수집하고, 무거운 캡처·이미지 처리는 비동기 워커와 큐로 분리했습니다. 조직·권한 관리, 구독 결제, 3개 언어(한·영·일)를 지원하는 실서비스입니다.
역할 · 서비스 전체 아키텍처 설계 및 개발 (1인)
시스템 아키텍처
제품 화면
문제 해결 기록
긴 페이지 캡처의 메모리 초과와 이미지 처리 구조 개선
- 문제긴 페이지 캡처 처리 중 메모리 초과(OOM)로 프로세스 종료
- 해결병합 단계 제거 및 타일 단위 합성으로 전환
- 성과피크 메모리 2GB → 600MB, 처리 시간 45초 → 15초
상세 보기 (원인 분석 · 설계 결정)상세 접기
긴 페이지는 스크롤하며 여러 번 나눠 캡처합니다. 이 캡처 조각들을 먼저 한 장의 초대형 이미지로 합친 뒤, 화면에 보여 줄 타일로 잘라 저장했습니다. 100MB가 넘는 이미지를 처리하면서 메모리를 2GB 이상 사용해 프로세스가 강제 종료(OOM)됐습니다.
처리 순서가 문제였습니다. 최종 결과물은 타일인데도, 그 전에 페이지 전체 크기의 이미지를 만들어 메모리에 올려 두고 압축까지 했습니다. 페이지가 길수록 메모리 사용량이 길이에 비례해 늘어나는 구조였습니다.
- ① 타일 단위로 바로 생성 · 브라우저 확장은 캡처 조각과 각 조각의 페이지 내 위치만 보냅니다. 서버는 1920×1080 격자를 순회하며, 각 타일 영역에 걸치는 캡처 조각만 잘라 합성했습니다. 페이지 전체 이미지를 만들지 않으므로 한 번에 만드는 이미지는 타일 한 장 크기입니다. 캡처 조각의 전처리는 병렬로 수행했습니다.
- ② 저장 형식과 업로드 · 타일을 PNG 대신 WebP(품질 92)로 저장해 용량을 줄였고, 업로드는 순차에서 병렬로 바꿨습니다.
브라우저 Canvas에는 높이 약 32,767px 제한이 있어, 브라우저에서 합치면 긴 페이지가 잘립니다. 확장은 캡처 조각과 위치만 모으고 조립은 서버가 맡게 해 캡처 길이 제한을 없앴습니다.
- 피크 메모리2GB→600MB
- 처리 시간45초→15초
- 타일 용량2MB→350KB
에너지 모니터링 시스템 (EMS)
2024.08 ~ 2025.10전력·태양광 계측 데이터를 실시간으로 수집·집계하는 에너지 모니터링 플랫폼
- CASE 015일+→20분600만 건 배치 (Paging → Cursor)
여러 곳에 분산된 전력·태양광 계측기에서 Modbus TCP로 데이터를 수집해 실시간으로 저장·집계하는 에너지 모니터링 플랫폼입니다. 원시 데이터는 MongoDB에, 1·15·60분 단위 집계는 MariaDB에 나누어 저장하고, 사용자·관리자 웹과 실시간 알림(SSE)까지 풀스택으로 개발했습니다.
역할 · 사용자/관리자 시스템 풀스택 개발 및 운영 (2인)
시스템 아키텍처
문제 해결 기록
600만 건 배치 성능 개선, Paging에서 Cursor로
- 문제600만 건 배치 처리에 5일 이상 소요
- 해결Paging Reader를 Cursor Reader로 교체
- 성과5일 이상 → 20분
상세 보기 (원인 분석 · 설계 결정)상세 접기
전력 데이터 백업·삭제 배치가 대량 데이터 처리 구간에서 비정상적으로 느려지는 문제를 확인했습니다. 삭제 로직을 제외하고 실행해도 처리 속도에 차이가 없어, 대량 데이터 조회 단계에서 병목이 발생한다고 판단했습니다.
처음에는 한 번에 처리하는 묶음 크기(Chunk Size)를 의심했습니다. 하지만 크기를 바꿔도 뒤쪽 구간으로 갈수록 느려지는 패턴은 그대로였습니다. 이에 데이터 조회 방식을 점검했습니다.
읽기에 쓰던 MongoPagingItemReader는 skip + limit으로 페이지를 읽습니다. 500만 번째 데이터를 읽으려면 앞의 약 500만 건을 조회한 뒤 건너뛰어야 합니다. 뒤로 갈수록 한 페이지를 읽는 비용이 커져, 전체 시간은 데이터 양의 제곱에 비례해 늘었습니다.
MongoCursorItemReader로 바꿔 커서를 한 번 열고 처음부터 순서대로 읽게 했습니다. 앞쪽 데이터를 반복해서 조회하는 비용이 사라졌습니다.
- 약 600만 건 처리5일 이상→20분
창고 관리 시스템 (WMS)
2024.07 ~ 2024.08종이로 처리하던 창고 입·출고와 재고 관리를 웹으로 옮긴 전산화 시스템
- 50%+↓입·출고 업무 처리 시간 (웹 전산화)
종이와 대면 확인으로 처리하던 창고 입·출고와 자재·재고 관리를 웹으로 전산화한 시스템입니다. 자재 마스터와 재고를 DB로 옮기고, 재고 수량을 따로 저장하는 대신 입·출고 내역으로 계산하는 구조로 설계해 수량 불일치를 줄이고 이력을 추적할 수 있게 했습니다. 배포까지 주도했습니다.
역할 · 초기 시스템 아키텍처 설계 및 풀스택 개발 · 업무 처리 시간 50%+ 단축